Biến gây nhiễu và ảnh hưởng đến suy luận nhân quả
Mục lục
Biến gây nhiễu có thể khiến một mối liên hệ quan sát được trông giống quan hệ nhân quả, mạnh hơn, yếu hơn hoặc thậm chí khác hướng so với tác động thực. Hiểu cơ chế gây nhiễu giúp phân biệt tương quan với nguyên nhân và lựa chọn cách kiểm soát phù hợp
Biến gây nhiễu là yếu tố liên quan đến cả biến được xem là nguyên nhân và kết quả, đồng thời không nằm trên con đường nhân quả mà ta đang muốn ước lượng. Khi không được tính đến, yếu tố này có thể làm cho mối quan hệ giữa nguyên nhân và kết quả bị sai lệch.
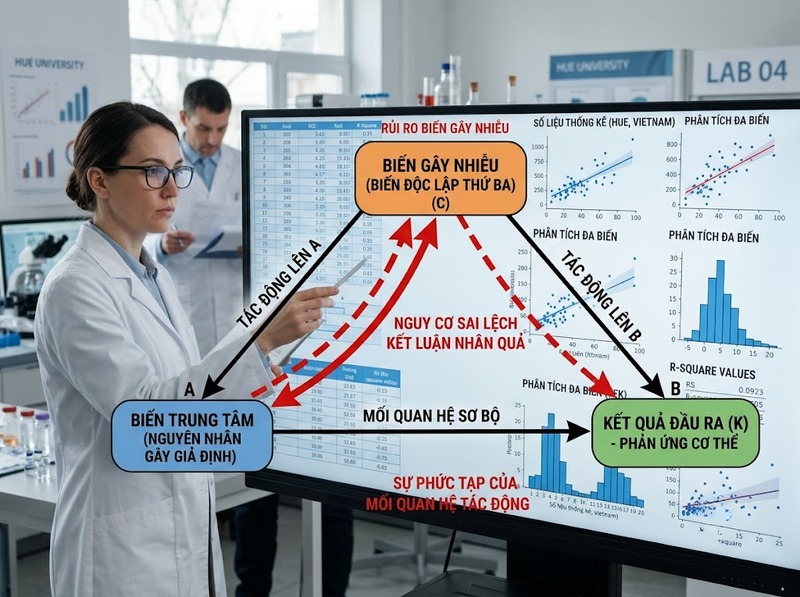
Điểm quan trọng là một mối liên hệ thống kê không tự chứng minh rằng biến này gây ra biến kia. Nếu một yếu tố thứ ba cùng tác động hoặc liên quan đến cả hai, dữ liệu quan sát có thể tạo ra một quan hệ dường như có tính nhân quả dù tác động thực tế nhỏ hơn, lớn hơn hoặc thậm chí không tồn tại.
Biến gây nhiễu là gì?
Trong suy luận nhân quả, có thể hình dung ba thành phần:
X → Y
Trong đó:
· X là yếu tố phơi nhiễm hoặc nguyên nhân được quan tâm
· Y là kết quả cần giải thích
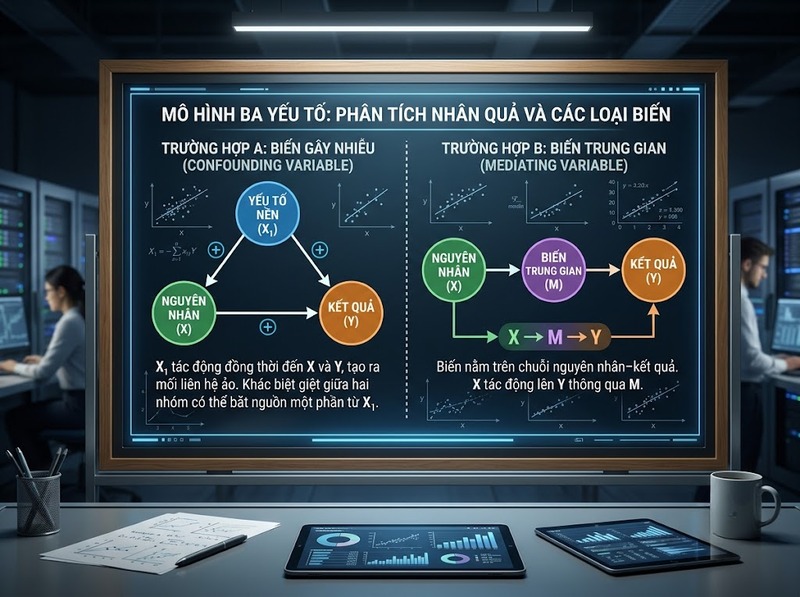
· C là biến gây nhiễu nếu C liên quan đến X và đồng thời là nguyên nhân của Y, nhưng không phải là trung gian nằm trên đường từ X đến Y
Khi đó, ngoài đường tác động mà ta muốn nghiên cứu, dữ liệu còn chứa một đường liên hệ khác:
C → X
C → Y
Vì X và C có liên quan, nhóm có X có thể khác nhóm không có X về C. Nếu C cũng ảnh hưởng đến Y, sự khác biệt về Y giữa hai nhóm có thể không hoàn toàn do X tạo ra.
Ví dụ, giả sử một nghiên cứu quan sát thấy mức độ uống cà phê cao có liên quan đến nguy cơ mắc một vấn đề sức khỏe. Nếu những người uống nhiều cà phê cũng có xu hướng hút thuốc nhiều hơn, và hút thuốc là yếu tố ảnh hưởng đến kết quả sức khỏe, thì hút thuốc có thể làm nhiễu mối quan hệ giữa cà phê và kết quả.
Khi đó, câu hỏi đúng không chỉ là:
“Nhóm uống nhiều cà phê có kết quả khác nhóm còn lại không?”
mà phải là:
“Sau khi loại bỏ khác biệt do yếu tố gây nhiễu, tác động riêng của cà phê còn lại bao nhiêu?”
Vì sao không phải mọi biến thứ ba đều là biến gây nhiễu?
Đây là ranh giới quan trọng trong phân tích nhân quả. Một biến có liên quan với X và Y chưa chắc đã nên được điều chỉnh.
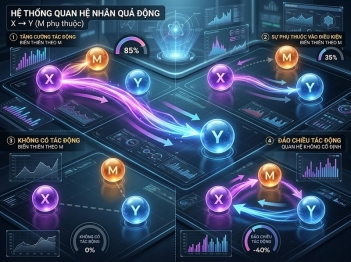
Nếu biến đó nằm trên chính con đường nhân quả:
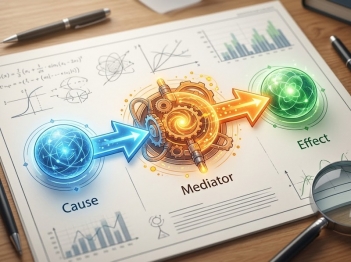
X → M → Y
thì M là biến trung gian, không phải biến gây nhiễu theo cách hiểu thông thường. Điều chỉnh cho M có thể làm mất một phần tác động của X mà nghiên cứu thực sự muốn đo.
Tương tự, việc điều chỉnh một biến không đúng vai trò nhân quả có thể tạo ra hoặc làm tăng sai lệch thay vì loại bỏ nó.
Biến gây nhiễu làm sai lệch quan hệ nguyên nhân – kết quả như thế nào?
Cơ chế cốt lõi là biến gây nhiễu tạo ra một phần của sự khác biệt về kết quả mà người phân tích có thể nhầm cho là tác động của X.
Có thể hình dung:
Tác động quan sát được = tác động của X ảnh hưởng do cấu trúc khác biệt giữa các nhóm
Nếu C đồng thời liên quan đến X và ảnh hưởng đến Y, hai nhóm được so sánh không còn tương đương về C. Vì vậy, chênh lệch Y giữa hai nhóm chứa cả tác động của X và phần chênh lệch liên quan đến C.
Điều này có thể dẫn đến ba tình huống chính.
Làm mối quan hệ trông mạnh hơn thực tế
Nếu C làm tăng Y và C phổ biến hơn ở nhóm có X, X có thể dường như có tác động lên Y lớn hơn tác động thực.
Ví dụ đơn giản:
· X: một đặc điểm nghề nghiệp
· Y: nguy cơ bệnh
· C: một yếu tố lối sống
Nếu C phổ biến hơn trong nhóm có X và bản thân C làm tăng nguy cơ bệnh, một phần nguy cơ cao quan sát được ở nhóm X thực chất đến từ C.
Làm mối quan hệ yếu hơn thực tế
Nhiễu cũng có thể che khuất một tác động thật. Khi ảnh hưởng của C phân bố khác nhau giữa các nhóm, phần biến thiên do C có thể làm giảm mức chênh lệch mà ta quan sát được giữa X và Y.
Kết quả là một tác động nhân quả tồn tại nhưng dữ liệu thô cho thấy tác động nhỏ hơn.
Thậm chí làm thay đổi hướng kết luận
Trong những cấu trúc dữ liệu nhất định, sau khi phân tầng hoặc điều chỉnh theo biến gây nhiễu, hướng hoặc độ lớn của mối liên hệ có thể thay đổi đáng kể so với kết quả chưa điều chỉnh.
Đây là lý do không thể kết luận về nguyên nhân chỉ bằng cách nhìn vào một hệ số tương quan hoặc một chênh lệch trung bình chưa được xem xét trong bối cảnh nhân quả.
Làm thế nào để phân biệt biến gây nhiễu với nguyên nhân, trung gian và yếu tố khác?
Phân biệt đúng vai trò của biến là bước quyết định trước khi điều chỉnh dữ liệu.
|
Loại biến |
Vai trò |
Có nên tự động điều chỉnh? |
|
Biến gây nhiễu |
Tạo ra đường liên hệ không mong muốn giữa X và Y |
Thường cần kiểm soát |
|
Biến trung gian |
Nằm trên đường X → M → Y |
Không nếu muốn ước lượng tổng tác động của X |
|
Yếu tố kết quả |
Bị X tác động |
Không thể xem như biến gây nhiễu trước X |
|
Biến không liên quan |
Không tạo ra thông tin nhân quả hữu ích |
Không cần thiết |
|
Collider |
Là điểm hội tụ của các đường nhân quả |
Điều chỉnh có thể tạo sai lệch |
Điểm đặc biệt quan trọng là không thể xác định vai trò nhân quả của một biến chỉ bằng tương quan thống kê. Cần dựa vào thứ tự thời gian, kiến thức về cơ chế và giả định về cấu trúc nhân quả.
Một ví dụ để tránh nhầm với biến trung gian
Giả sử:
Tập luyện → giảm cân → cải thiện một chỉ số sức khỏe
Cân nặng ở đây có thể là trung gian. Nếu mục tiêu là đo tổng tác động của tập luyện lên chỉ số sức khỏe, điều chỉnh cho cân nặng có thể loại bỏ phần tác động đi qua cơ chế giảm cân.
Ngược lại, nếu có một yếu tố tồn tại trước khi bắt đầu tập luyện, liên quan đến việc một người có tập luyện hay không và đồng thời ảnh hưởng đến chỉ số sức khỏe, yếu tố đó mới có thể đóng vai trò biến gây nhiễu.
Xác định và kiểm soát biến gây nhiễu bằng cách nào?
Không nên bắt đầu bằng việc “đưa tất cả biến có trong dữ liệu vào mô hình”. Kiểm soát nhiễu trước hết là một bài toán về cấu trúc nhân quả, sau đó mới là bài toán thống kê.
1. Xác định các yếu tố có khả năng gây nhiễu
Cần xem xét:
· Yếu tố nào có trước X về mặt thời gian?
· Yếu tố nào có liên quan đến khả năng xuất hiện X?
· Yếu tố nào cũng ảnh hưởng đến Y?
· Yếu tố nào thực sự nằm ngoài đường tác động X → Y?
Sơ đồ nhân quả có hướng, thường gọi là DAG, là một công cụ hữu ích để biểu diễn các quan hệ này.
2. So sánh trước và sau khi kiểm soát
Có thể sử dụng các phương pháp như:
· Phân tầng
· Ghép cặp
· Hồi quy
· Chuẩn hóa
· Trọng số xác suất
· Thiết kế nghiên cứu có kiểm soát
Mục tiêu không phải đơn giản là “làm cho kết quả đẹp hơn”, mà là tạo ra phép so sánh trong đó khác biệt do các yếu tố gây nhiễu được kiểm soát theo giả định nhân quả đã chọn.
3. Randomization khi có thể
Trong thử nghiệm ngẫu nhiên, việc phân bổ X một cách ngẫu nhiên giúp các yếu tố gây nhiễu được phân bố cân bằng hơn giữa các nhóm về mặt kỳ vọng.
Đây là một lý do quan trọng khiến thiết kế thử nghiệm ngẫu nhiên có lợi thế trong suy luận nhân quả so với nghiên cứu quan sát.
Tuy nhiên, trong nhiều lĩnh vực không thể hoặc không phù hợp để ngẫu nhiên hóa. Khi đó, việc xác định cấu trúc gây nhiễu và lựa chọn chiến lược điều chỉnh trở thành phần trung tâm của phân tích.
Vì sao kiểm soát sai biến gây nhiễu vẫn có thể làm kết quả sai?
Một sai lầm phổ biến là nghĩ rằng càng điều chỉnh nhiều biến thì kết quả càng chính xác. Điều này không đúng.
Điều chỉnh một biến không phù hợp có thể:
· loại bỏ một phần tác động mà ta thực sự muốn đo
· tạo ra một đường liên hệ không tồn tại trước đó
· làm tăng sai lệch
· khiến kết quả khó diễn giải về mặt nhân quả
Do đó, mục tiêu không phải là kiểm soát mọi biến có liên quan đến X hoặc Y, mà là xác định tập biến điều chỉnh phù hợp với câu hỏi nhân quả.
Đặc biệt, cần tránh điều chỉnh máy móc cho biến trung gian hoặc collider. Một mô hình thống kê có nhiều biến kiểm soát chưa chắc là một mô hình nhân quả tốt.
Khi có biến gây nhiễu, quan hệ quan sát được giữa X và Y không còn là bằng chứng đủ mạnh để kết luận X là nguyên nhân của Y. Biến gây nhiễu có thể làm tác động quan sát được bị phóng đại, bị che khuất hoặc thay đổi đáng kể so với tác động thực.
Vì vậy, muốn xác định nguyên nhân, cần đi qua ba bước: xác định cấu trúc nhân quả, nhận diện các biến gây nhiễu và lựa chọn chiến lược kiểm soát phù hợp. Quan trọng nhất, không phải cứ có một biến thứ ba là phải điều chỉnh; việc điều chỉnh phải dựa trên vai trò nhân quả của biến đó và mục tiêu tác động đang được ước lượng.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm
Bài xem nhiều
