Cách thiết kế giải pháp có khả năng mở rộng
Mục lục
- Thiết kế kiến trúc mở rộng ngang thay vì chỉ tăng cấu hình
- Thiết kế dữ liệu để tránh database trở thành điểm nghẽn
- Tách tác vụ đồng bộ và bất đồng bộ để kiểm soát tải
- Chuẩn bị observability và cơ chế tự động mở rộng
- Chuẩn bị nguồn lực, ngân sách và giới hạn vận hành
- Kiểm thử khả năng mở rộng trước khi đưa vào vận hành
Để thiết kế giải pháp có khả năng mở rộng, cần xác định trước mô hình tăng trưởng, kiến trúc mở rộng ngang, điểm nghẽn dữ liệu, cơ chế xử lý bất đồng bộ, khả năng quan sát và nguồn lực vận hành
Xác định đúng bài toán mở rộng trước khi chọn kiến trúc
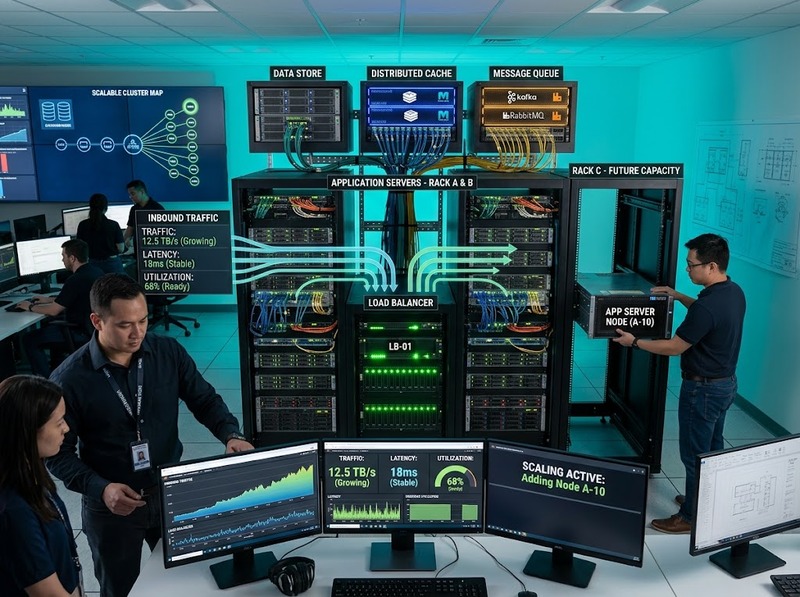
Thiết kế giải pháp có khả năng mở rộng không đơn thuần là tăng thêm máy chủ khi lượng người dùng tăng. Mục tiêu là xây dựng hệ thống có thể tiếp nhận mức tải lớn hơn mà hiệu năng, độ ổn định và chi phí vẫn nằm trong giới hạn chấp nhận được.
Trước khi chọn công nghệ, cần xác định hệ thống sẽ tăng theo hướng nào:
· Số lượng người dùng hoặc request
· Lưu lượng dữ liệu
· Kích thước dữ liệu lưu trữ
· Tần suất các tác vụ nặng
· Số lượng tenant hoặc khách hàng
· Mức độ phức tạp của nghiệp vụ
Từ đó, các chỉ số cần theo dõi có thể gồm request/giây, độ trễ p95 hoặc p99, tỷ lệ lỗi, CPU, bộ nhớ, I/O, số kết nối cơ sở dữ liệu và chi phí trên mỗi đơn vị tải.
Điểm quan trọng là khả năng mở rộng phải được thiết kế theo bottleneck thực tế, không phải theo giả định rằng mọi thành phần đều tăng tải giống nhau.
Thiết kế kiến trúc mở rộng ngang thay vì chỉ tăng cấu hình
Có hai hướng mở rộng cơ bản: mở rộng dọc bằng cách tăng CPU, RAM hoặc năng lực của một máy; và mở rộng ngang bằng cách bổ sung nhiều instance cùng đảm nhiệm một chức năng.
Đối với hệ thống có tốc độ tăng trưởng không chắc chắn, mở rộng ngang thường tạo nền tảng linh hoạt hơn. Một kiến trúc điển hình có thể gồm:
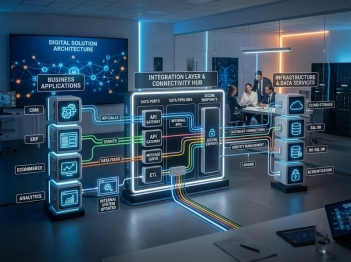
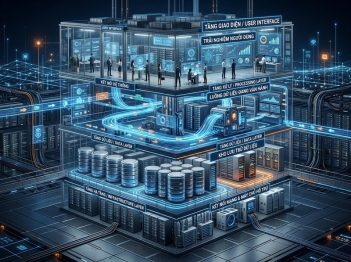
Client → Load Balancer → Application Instances → Cache / Database / Message Queue
Ứng dụng nên ưu tiên stateless khi có thể. Khi trạng thái phiên không bị giữ cố định trên một instance, request có thể được phân phối sang nhiều instance khác nhau và việc scale-out trở nên đơn giản hơn.
Tuy nhiên, scale ngang không tự động giải quyết mọi vấn đề. Nếu toàn bộ application instances cùng phụ thuộc vào một database duy nhất, database có thể trở thành điểm nghẽn mới. Vì vậy, thiết kế mở rộng phải xem xét toàn bộ chuỗi phụ thuộc, từ tầng truy cập đến xử lý, dữ liệu và các dịch vụ bên ngoài.

Thiết kế dữ liệu để tránh database trở thành điểm nghẽn
Trong nhiều hệ thống, tầng application có thể tăng từ vài instance lên hàng chục instance tương đối dễ dàng, trong khi database khó mở rộng tương ứng. Vì vậy, khả năng mở rộng của dữ liệu cần được thiết kế từ sớm.
Các cơ chế có thể được xem xét gồm:
· Index phù hợp với workload thực tế
· Connection pooling và giới hạn connection
· Read replica cho workload đọc lớn
· Caching cho dữ liệu được truy cập thường xuyên
· Partitioning khi kích thước hoặc workload dữ liệu tăng mạnh
· Sharding khi một database đơn không còn đáp ứng được yêu cầu
· Object storage cho dữ liệu lớn không cần nằm trong transactional database
Cần phân biệt rõ read-heavy và write-heavy workload. Read replica có thể giảm tải đọc nhưng không giải quyết trực tiếp bottleneck của ghi. Cache có thể giảm số lần truy vấn database nhưng tạo thêm bài toán invalidation, stale data và nhất quán dữ liệu.
Vì vậy, mỗi quyết định về database phải gắn với workload cụ thể thay vì mặc định rằng một kỹ thuật nhất định luôn giúp hệ thống scale tốt hơn.
Tách tác vụ đồng bộ và bất đồng bộ để kiểm soát tải
Không phải mọi request đều cần hoàn thành toàn bộ công việc trước khi trả response cho người dùng.
Các tác vụ như gửi email, xử lý file, tạo báo cáo, đồng bộ dữ liệu hoặc thực hiện một quy trình tính toán dài có thể được đưa vào message queue để xử lý bất đồng bộ.
Mô hình này giúp tách tốc độ tiếp nhận request khỏi tốc độ xử lý tác vụ. Khi tải tăng, worker có thể được scale riêng theo độ dài queue hoặc throughput cần đạt.
Tuy nhiên, kiến trúc bất đồng bộ cũng tạo ra các yêu cầu mới:
· Xử lý retry
· Idempotency để tránh thực hiện cùng một tác vụ nhiều lần
· Dead-letter queue cho message lỗi
· Theo dõi trạng thái xử lý
· Kiểm soát thứ tự message khi nghiệp vụ yêu cầu
· Xác định mức độ chấp nhận được của eventual consistency
Do đó, queue không nên được thêm chỉ để làm kiến trúc “hiện đại” hơn. Nó phù hợp khi việc tách thời gian tiếp nhận và thời gian xử lý thực sự giải quyết một bottleneck hoặc yêu cầu về khả năng chịu tải.
Chuẩn bị observability và cơ chế tự động mở rộng
Một hệ thống không thể scale ổn định nếu đội vận hành không biết nó đang tiến gần giới hạn nào.
Observability nên bao phủ ít nhất ba nhóm:
· Metrics: throughput, latency, error rate, CPU, memory, database connection, queue depth
· Logs: lỗi ứng dụng, sự kiện quan trọng và thông tin phục vụ điều tra
· Traces: đường đi của request qua nhiều service
Các ngưỡng scale cũng cần gắn với đặc tính workload. CPU cao có thể là tín hiệu phù hợp cho một service tính toán nặng nhưng không nhất thiết phản ánh bottleneck của service chờ I/O. Với worker bất đồng bộ, queue depth hoặc processing lag có thể có giá trị hơn CPU.
Autoscaling chỉ hiệu quả khi metric phản ánh đúng áp lực tải và hệ thống có đủ capacity để hấp thụ tốc độ tăng trưởng trong thời gian scale-out diễn ra. Nếu traffic tăng nhanh hơn tốc độ khởi tạo tài nguyên, hệ thống vẫn có thể bị quá tải dù đã bật autoscaling.
Chuẩn bị nguồn lực, ngân sách và giới hạn vận hành
Khả năng mở rộng không chỉ là vấn đề kiến trúc mà còn là bài toán nguồn lực.
Trước khi triển khai nên lập capacity model dựa trên:
Tải dự kiến → Tài nguyên cần thiết → Chi phí → Ngưỡng mở rộng
Nguồn lực cần tính đến gồm:
· Compute
· Database
· Cache
· Storage
· Network
· Message broker
· Monitoring và logging
· Backup và disaster recovery
· Nhân sự vận hành
· Ngân sách cho tăng trưởng
Nên xây dựng ít nhất ba kịch bản: tải thông thường, tải cao và tải đột biến. Với mỗi kịch bản, cần biết hệ thống đạt throughput nào, latency ở mức nào, thành phần nào chạm giới hạn trước và cần bổ sung tài nguyên ở đâu.
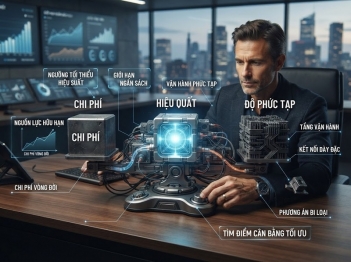
Một kiến trúc có thể mở rộng về mặt kỹ thuật nhưng không khả thi về chi phí vẫn chưa phải một giải pháp tốt. Ngược lại, tối ưu chi phí quá mức có thể khiến hệ thống thiếu headroom và dễ thất bại khi tải tăng đột biến.
Kiểm thử khả năng mở rộng trước khi đưa vào vận hành
Không nên kết luận một giải pháp “có khả năng mở rộng” chỉ dựa trên sơ đồ kiến trúc.
Cần kiểm thử bằng workload gần với thực tế để xác định:
· Throughput tối đa
· p95/p99 latency
· Error rate
· Resource utilization
· Database capacity
· Queue processing rate
· Thời gian scale-out
· Hành vi khi một thành phần bị quá tải
Có thể sử dụng load test, stress test và endurance test tùy mục tiêu. Kết quả nên được so sánh với SLO hoặc các ngưỡng vận hành đã xác định trước.
Quan trọng hơn, phải xác định điểm thất bại đầu tiên. Nếu application chịu được 10.000 request/giây nhưng database chỉ đáp ứng được một phần nhỏ mức tải đó, con số 10.000 không đại diện cho khả năng mở rộng thực tế của toàn hệ thống.
Để thiết kế giải pháp có khả năng mở rộng, cần bắt đầu từ mô hình tăng trưởng và workload, sau đó mới lựa chọn kiến trúc. Nền tảng thường gồm application có thể scale ngang, tầng dữ liệu được thiết kế theo workload, cơ chế cache và bất đồng bộ khi phù hợp, observability, autoscaling, capacity planning và ngân sách vận hành. Cuối cùng, các giả định phải được kiểm chứng bằng benchmark hoặc load test thay vì chỉ dựa trên thiết kế lý thuyết.

GỬI Ý KIẾN BÌNH LUẬN