Cách xác định điểm thất bại tiềm ẩn của giải pháp
Mục lục
- Xác định điểm thất bại từ các phụ thuộc bắt buộc của giải pháp
- Tìm phụ thuộc ẩn và phụ thuộc chung có thể làm nhiều thành phần cùng thất bại
- Chuyển từng phụ thuộc thành kịch bản lỗi cụ thể
- Kiểm tra lỗi đơn lẻ, lỗi kết hợp và khả năng lan truyền
- Đánh giá khả năng phát hiện, cô lập và phục hồi sau lỗi
- Ưu tiên các điểm thất bại theo hậu quả thay vì chỉ theo khả năng xảy ra
- Xác nhận điểm thất bại bằng thử nghiệm thay vì chỉ dựa trên sơ đồ
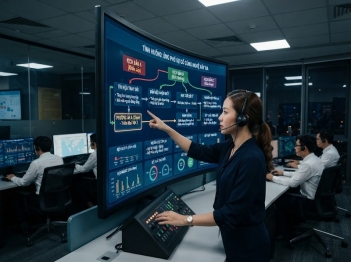
Điểm thất bại tiềm ẩn của giải pháp được xác định bằng cách lập bản đồ phụ thuộc, giả định từng phụ thuộc bị gián đoạn, mô phỏng chuỗi lỗi và kiểm tra khả năng phát hiện, cô lập, phục hồi của toàn hệ thống.
Một điểm chỉ thực sự là điểm thất bại của giải pháp khi sự cố tại đó có thể khiến giải pháp không còn đạt mục tiêu, trực tiếp hoặc thông qua một chuỗi phụ thuộc. Vì vậy, không nên bắt đầu bằng câu hỏi “thành phần nào dễ hỏng nhất?”, mà bằng ba câu hỏi: giải pháp đang phụ thuộc vào đâu, phụ thuộc đó có thể thất bại theo cách nào và lỗi sẽ lan truyền đến kết quả cuối cùng ra sao.
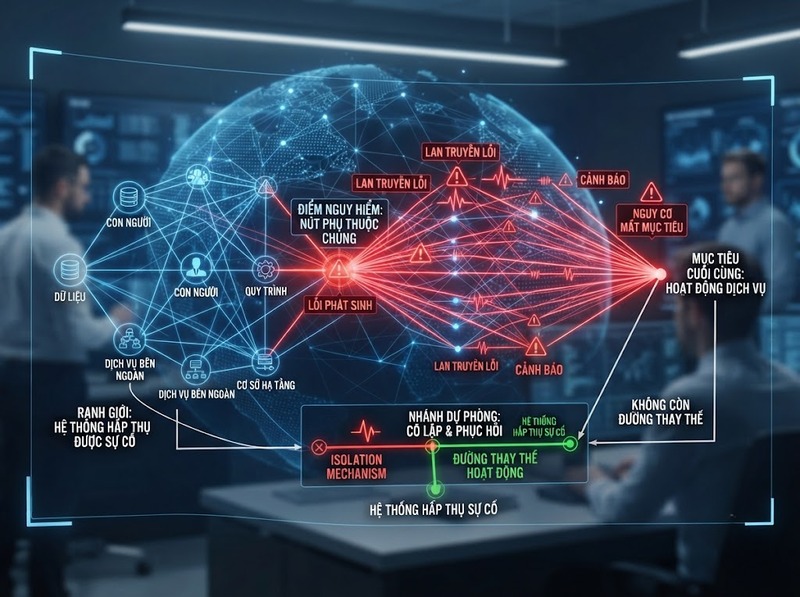
Cách phân tích hiệu quả là đi từ mục tiêu → phụ thuộc → chế độ lỗi → điều kiện kích hoạt → hậu quả → khả năng phát hiện và phục hồi. Một thành phần có xác suất hỏng thấp vẫn có thể là điểm thất bại nghiêm trọng nếu không có phương án thay thế. Ngược lại, một thành phần thường xuyên gặp lỗi nhưng được cô lập và phục hồi tự động có thể không phải điểm thất bại quyết định.
Xác định điểm thất bại từ các phụ thuộc bắt buộc của giải pháp
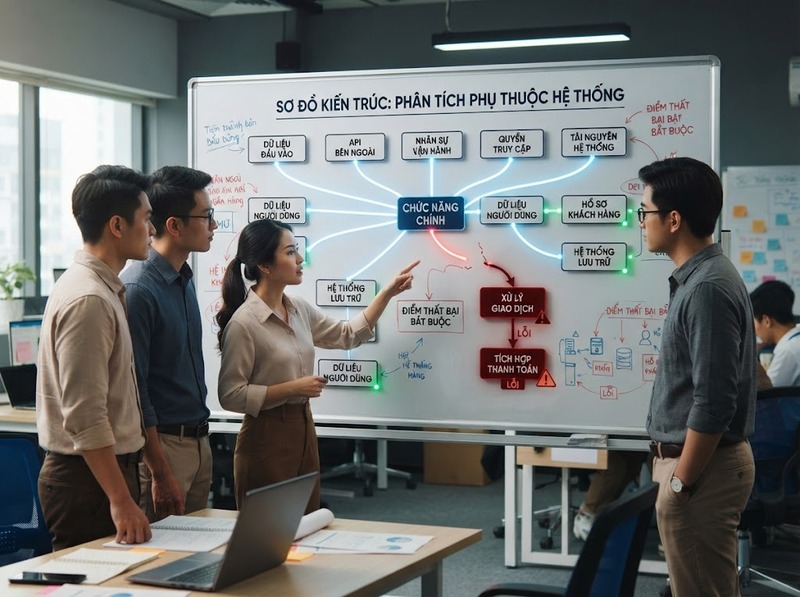
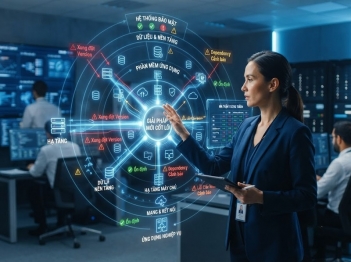
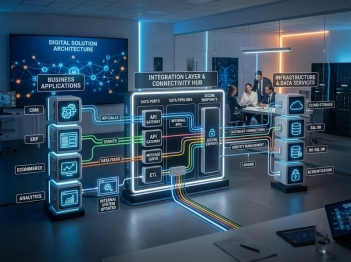
Bước đầu tiên là xác định những điều kiện mà giải pháp buộc phải có để tạo ra kết quả mong muốn. Phụ thuộc không chỉ là các bộ phận hữu hình. Nó có thể nằm ở dữ liệu đầu vào, con người, quy trình, hệ thống bên ngoài, nguồn lực, quyền truy cập, giả định nghiệp vụ hoặc trình tự thực hiện.
Có thể biểu diễn logic cơ bản như sau:
Mục tiêu của giải pháp → chức năng cần hoạt động → nguồn lực hoặc điều kiện mà chức năng phụ thuộc
Ví dụ, một quy trình tự động có thể phụ thuộc đồng thời vào dữ liệu đầu vào chính xác, API của hệ thống khác, quyền truy cập hợp lệ và cơ chế xử lý ngoại lệ. Nếu chỉ kiểm tra phần mềm nội bộ mà bỏ qua ba phụ thuộc còn lại, nhiều điểm thất bại thực tế sẽ không được nhìn thấy.
Mỗi phụ thuộc nên được kiểm tra bằng câu hỏi: “Nếu yếu tố này biến mất, sai lệch hoặc hoạt động chậm hơn dự kiến thì giải pháp còn đạt mục tiêu không?”
Nếu câu trả lời là “không”, và không tồn tại đường thay thế đủ khả năng duy trì chức năng, phụ thuộc đó là ứng viên có mức ưu tiên cao để phân tích như một điểm thất bại.
Một lỗi thường gặp là đồng nhất “điểm thất bại” với “bộ phận dễ hỏng”. Mức độ quan trọng thực tế phụ thuộc nhiều hơn vào hậu quả của lỗi và khả năng hệ thống hấp thụ lỗi. Một mắt xích rất ổn định vẫn có thể tạo rủi ro lớn nếu toàn bộ giải pháp phụ thuộc duy nhất vào nó.
Tìm phụ thuộc ẩn và phụ thuộc chung có thể làm nhiều thành phần cùng thất bại
Bản đồ phụ thuộc trực tiếp chưa đủ vì nhiều giải pháp có vẻ phân tán nhưng thực tế lại chia sẻ một nguồn phụ thuộc phía sau.
Hai thành phần có thể trông như hai đường dự phòng độc lập nhưng cùng sử dụng:
· Một nguồn dữ liệu
· Một dịch vụ xác thực
· Một nhà cung cấp
· Một hạ tầng mạng
· Một tài khoản hoặc quyền quản trị
· Một quy trình vận hành
· Một nhóm nhân sự
· Một giả định nghiệp vụ
Khi nguồn chung đó gặp sự cố, cả đường chính lẫn đường dự phòng có thể mất tác dụng. Đây là lý do phải kiểm tra không chỉ quan hệ A phụ thuộc B, mà cả quan hệ A và B cùng phụ thuộc C.
Phụ thuộc gián tiếp cũng cần được lần theo. Nếu A cần B, B cần C và C cần D, lỗi tại D có thể biểu hiện cuối cùng như lỗi của A. Nếu chỉ quan sát tầng gần đầu ra, nguyên nhân gốc dễ bị bỏ sót.
Một phép kiểm tra hữu ích là lần ngược từ mỗi chức năng thiết yếu và hỏi liên tục:
“Điều gì phải đúng để thành phần này hoạt động?”
Tiếp tục cho đến khi gặp một điều kiện đã được kiểm soát độc lập hoặc một phụ thuộc nằm ngoài khả năng kiểm soát của giải pháp. Những nơi nhiều nhánh hội tụ vào cùng một điều kiện thường đáng được xem xét kỹ vì chúng có khả năng tạo lỗi lan truyền trên diện rộng.
Chuyển từng phụ thuộc thành kịch bản lỗi cụ thể
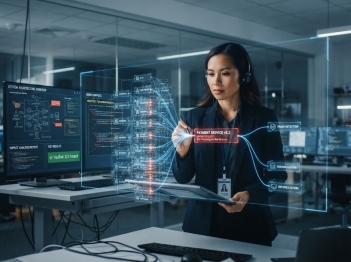
Biết một phụ thuộc tồn tại chưa đủ để nhận diện thất bại. Cần xác định phụ thuộc đó có thể sai theo những cách nào.
Không nên chỉ thử kịch bản nhị phân “hoạt động” và “không hoạt động”. Một thành phần có thể vẫn chạy nhưng cung cấp kết quả sai, chậm, không đầy đủ hoặc không nhất quán. Các dạng lỗi thường cần kiểm tra gồm:
· Không có đầu vào khi cần
· Đầu vào có nhưng sai
· Đầu vào đến quá muộn
· Đầu vào chỉ thiếu một phần
· Thành phần trả về kết quả không nhất quán
· Năng lực xử lý không đủ khi tải tăng
· Quyền truy cập bị mất hoặc thay đổi
· Một bước được thực hiện sai thứ tự
· Hệ thống phụ thuộc hoạt động nhưng hành vi khác giả định
· Cơ chế dự phòng không kích hoạt hoặc kích hoạt quá muộn
Mỗi kịch bản nên có cấu trúc:
Điều kiện kích hoạt → chế độ lỗi → ảnh hưởng cục bộ → lỗi lan truyền → ảnh hưởng đến mục tiêu
Ví dụ, thay vì ghi “API bên ngoài là một rủi ro”, cần mô tả rõ hơn:
API phản hồi chậm → bước lấy dữ liệu vượt thời gian xử lý → dữ liệu không được cập nhật → quyết định sử dụng dữ liệu cũ → đầu ra của giải pháp không còn đáp ứng điều kiện yêu cầu
Khi mô tả được chuỗi này, điểm thất bại trở nên kiểm chứng được. Nếu không xây dựng được con đường hợp lý từ sự cố đến việc mất mục tiêu, chưa đủ cơ sở để coi yếu tố đó là một điểm thất bại quan trọng.
Kiểm tra lỗi đơn lẻ, lỗi kết hợp và khả năng lan truyền
Một giải pháp có thể chịu được từng lỗi riêng biệt nhưng thất bại khi hai điều kiện bất lợi xuất hiện đồng thời. Vì vậy, sau các kịch bản lỗi đơn cần kiểm tra các tổ hợp có quan hệ thực tế.
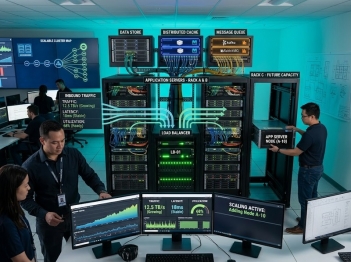
Chẳng hạn, cơ chế dự phòng có thể xử lý được lỗi của hệ thống chính trong điều kiện bình thường. Nhưng nếu lỗi xảy ra đúng lúc tải tăng mạnh, dữ liệu đồng bộ chưa hoàn tất hoặc nhân sự vận hành không sẵn sàng, phương án dự phòng có thể không còn đủ năng lực.
Cần phân biệt ba trường hợp:
Lỗi cục bộ chỉ ảnh hưởng một thành phần và được hệ thống hấp thụ.
Lỗi lan truyền bắt đầu tại một thành phần nhưng làm những thành phần phụ thuộc phía sau mất chức năng.
Lỗi kết hợp chỉ trở nên nghiêm trọng khi nhiều điều kiện hoặc nhiều chế độ lỗi cùng tồn tại.
Điểm đáng ưu tiên nhất không nhất thiết là nơi lỗi bắt đầu, mà thường là nơi lỗi vượt qua khả năng cô lập và bắt đầu làm mất chức năng thiết yếu.
Vì vậy, với mỗi kịch bản nên xác định rõ: lỗi dừng ở đâu, điều gì ngăn lỗi lan tiếp và điều kiện nào khiến lớp bảo vệ đó thất bại. Cách tiếp cận này giúp phân biệt một sự cố có thể xử lý bình thường với một điểm có khả năng làm toàn bộ giải pháp mất hiệu lực.
Đánh giá khả năng phát hiện, cô lập và phục hồi sau lỗi
Hai điểm có hậu quả ban đầu giống nhau có thể mang mức rủi ro rất khác nếu một lỗi được phát hiện ngay còn lỗi kia tồn tại âm thầm.
Mỗi điểm thất bại nên được kiểm tra theo ít nhất bốn câu hỏi:
1. Có nhận biết được lỗi không?
2. Lỗi có tạo cảnh báo, tín hiệu bất thường hoặc chỉ được phát hiện khi hậu quả đã xuất hiện?
3. Có biết lỗi nằm ở đâu không?
4. Phát hiện hệ thống hoạt động sai không đồng nghĩa với xác định được thành phần gây lỗi.
5. Có cô lập được lỗi không?
6. Một sự cố nhỏ sẽ được giới hạn trong phạm vi ban đầu hay tiếp tục ảnh hưởng các thành phần khác?
7. Có phục hồi được chức năng không?
8. Giải pháp có chuyển sang đường dự phòng, trạng thái suy giảm an toàn hoặc quy trình thủ công phù hợp hay không?
Điểm thất bại đặc biệt đáng chú ý khi hội tụ ba đặc tính: ảnh hưởng lớn, khó phát hiện và khó phục hồi. Khi đó, hệ thống có thể tiếp tục hoạt động trong trạng thái sai cho đến khi hậu quả đã lan rộng.
Cũng cần kiểm tra chính cơ chế bảo vệ. Dự phòng, cảnh báo và phục hồi không nên được mặc định là luôn hoạt động. Chúng cũng có phụ thuộc, điều kiện kích hoạt và chế độ lỗi riêng. Một phương án dự phòng chưa từng được kiểm tra trong điều kiện thất bại thực tế chỉ là một giả định về khả năng phục hồi.
Ưu tiên các điểm thất bại theo hậu quả thay vì chỉ theo khả năng xảy ra
Sau khi lập danh sách kịch bản lỗi, không nên xử lý mọi điểm như nhau. Mục tiêu là tìm những nơi cần kiểm soát trước.
Có thể đánh giá mỗi kịch bản trên các chiều:
· Mức độ ảnh hưởng: lỗi làm giảm hiệu suất hay làm mất hoàn toàn mục tiêu
· Khả năng xảy ra: điều kiện kích hoạt có thường xuất hiện hay không
· Khả năng phát hiện: có thể nhận biết trước khi hậu quả trở nên nghiêm trọng hay không
· Khả năng lan truyền: lỗi có bị giới hạn hay ảnh hưởng nhiều chức năng
· Khả năng phục hồi: có đường thay thế và thời gian phục hồi chấp nhận được hay không
· Mức độ phụ thuộc: có bao nhiêu chức năng thiết yếu cùng dựa vào điểm đó
Không nên dùng một điểm số tổng hợp như một kết luận tuyệt đối. Hai rủi ro có tổng điểm giống nhau có thể cần cách xử lý rất khác nếu một trường hợp có hậu quả cực lớn nhưng hiếm gặp, còn trường hợp kia xảy ra thường xuyên nhưng dễ phục hồi.
Điều quan trọng hơn là giữ được nguyên nhân của mức ưu tiên. Một điểm nên được đưa lên đầu danh sách khi thất bại của nó tạo hậu quả không thể chấp nhận, không có đường thay thế đáng tin cậy hoặc có khả năng làm nhiều lớp bảo vệ cùng mất tác dụng.
Xác nhận điểm thất bại bằng thử nghiệm thay vì chỉ dựa trên sơ đồ
Phân tích phụ thuộc tạo ra giả thuyết về nơi giải pháp có thể thất bại. Thử nghiệm mới cho biết giả thuyết đó có đúng trong vận hành hay không.
Với từng điểm quan trọng, có thể chủ động tạo điều kiện lỗi ở phạm vi kiểm soát và quan sát:
Lỗi có được phát hiện không → hệ thống phản ứng thế nào → lỗi có lan truyền không → cơ chế dự phòng có hoạt động không → mục tiêu còn được duy trì không → phục hồi cần những gì
Thử nghiệm cần phản ánh đúng loại thất bại đã xác định. Nếu rủi ro là phản hồi chậm, chỉ kiểm tra trạng thái mất kết nối hoàn toàn sẽ không đủ. Nếu rủi ro nằm ở dữ liệu sai nhưng hợp lệ về định dạng, thử nghiệm dữ liệu trống cũng không chứng minh được khả năng xử lý trường hợp đó.
Sau khi thêm biện pháp kiểm soát, phải chạy lại chính kịch bản lỗi. Việc có thêm dự phòng, cảnh báo hoặc quy trình xử lý chưa chứng minh điểm thất bại đã được loại bỏ; nó chỉ thay đổi chuỗi thất bại. Phân tích cần kiểm tra xem điểm yếu đã thực sự được loại bỏ, được cô lập hay chỉ chuyển sang một phụ thuộc khác.
Điểm thất bại tiềm ẩn vì thế được xác định đáng tin cậy nhất bằng một chuỗi logic nhất quán: lập bản đồ điều kiện bắt buộc, tìm phụ thuộc trực tiếp và phụ thuộc chung, giả định các chế độ lỗi, lần theo hậu quả đến mục tiêu, kiểm tra lớp bảo vệ và xác nhận bằng kịch bản thử nghiệm.
Một yếu tố chỉ nên được coi là điểm thất bại trọng yếu khi có thể chỉ ra rõ nó thất bại trong điều kiện nào, lỗi truyền qua những phụ thuộc nào, hậu quả cuối cùng là gì và vì sao các cơ chế hiện có không đủ để ngăn hoặc phục hồi lỗi. Khi bốn câu hỏi này được trả lời, việc xử lý rủi ro cũng trở nên cụ thể hơn: loại bỏ phụ thuộc, tạo đường thay thế, cô lập lỗi, phát hiện sớm hoặc giảm hậu quả thay vì chỉ ghi nhận một danh sách rủi ro chung chung.

GỬI Ý KIẾN BÌNH LUẬN