Điểm lỗi đơn và rủi ro đối với hệ thống
Mục lục
- Điểm lỗi đơn là gì trong kiến trúc công nghệ?
- Vì sao điểm lỗi đơn có thể làm gián đoạn toàn hệ thống?
- Những loại điểm lỗi đơn phổ biến trong hệ thống công nghệ
- Rủi ro khi hệ thống tồn tại điểm lỗi đơn
- Cách phát hiện điểm lỗi đơn trong kiến trúc hệ thống
- Cách loại bỏ hoặc giảm rủi ro từ điểm lỗi đơn
- Điểm lỗi đơn khác gì với lỗi thông thường trong hệ thống?
- Ý nghĩa của việc loại bỏ điểm lỗi đơn trong thiết kế hệ thống
Điểm lỗi đơn là một thành phần có thể khiến toàn bộ hệ thống công nghệ ngừng hoạt động khi xảy ra sự cố. Hiểu rõ nguyên nhân, rủi ro và cách loại bỏ điểm lỗi đơn giúp xây dựng kiến trúc hệ thống ổn định hơn
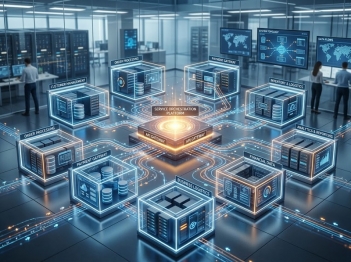
Trong kiến trúc công nghệ, một hệ thống có thể được cấu thành từ nhiều thành phần như máy chủ, cơ sở dữ liệu, mạng, dịch vụ ứng dụng, thiết bị lưu trữ hoặc các nền tảng trung gian. Tuy nhiên, chỉ cần một thành phần duy nhất bị lỗi và không có phương án thay thế, toàn bộ hệ thống có thể bị gián đoạn.
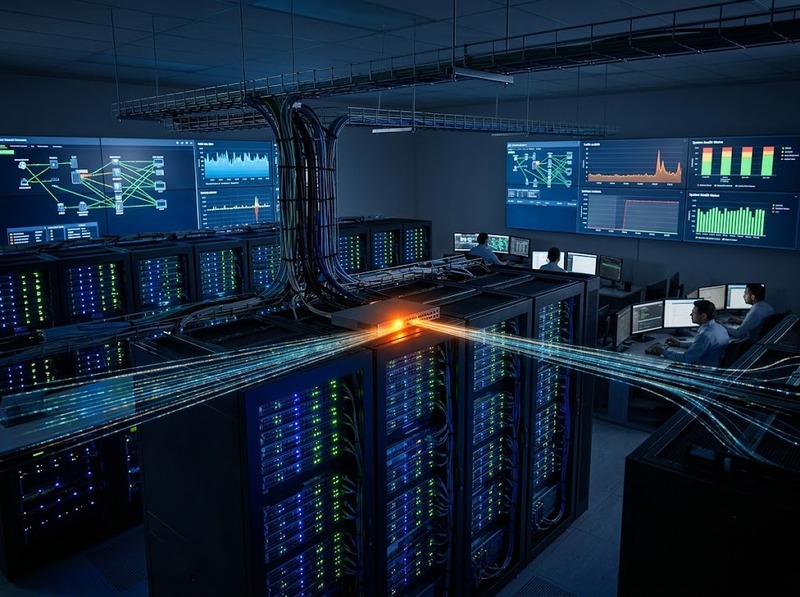
Thành phần đó được gọi là điểm lỗi đơn (Single Point of Failure - SPOF).
Điểm lỗi đơn là gì trong kiến trúc công nghệ?
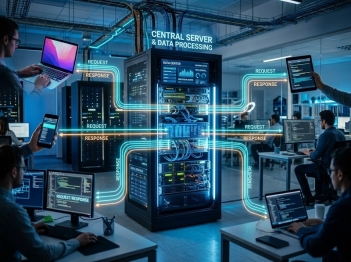
Điểm lỗi đơn là một thành phần hoặc một điểm phụ thuộc trong hệ thống mà khi xảy ra sự cố tại đó, khả năng vận hành của toàn bộ hệ thống bị ảnh hưởng nghiêm trọng hoặc dừng hoàn toàn.
Nói cách khác, đây là vị trí mà hệ thống chỉ có một đường hoạt động duy nhất. Nếu đường đó bị gián đoạn, không có cơ chế dự phòng để tiếp tục cung cấp dịch vụ.
Ví dụ:
· Một ứng dụng chỉ chạy trên một máy chủ duy nhất
· Một cơ sở dữ liệu không có bản sao dự phòng
· Một bộ định tuyến duy nhất kết nối toàn bộ mạng nội bộ
· Một dịch vụ xác thực duy nhất mà mọi ứng dụng đều phụ thuộc vào
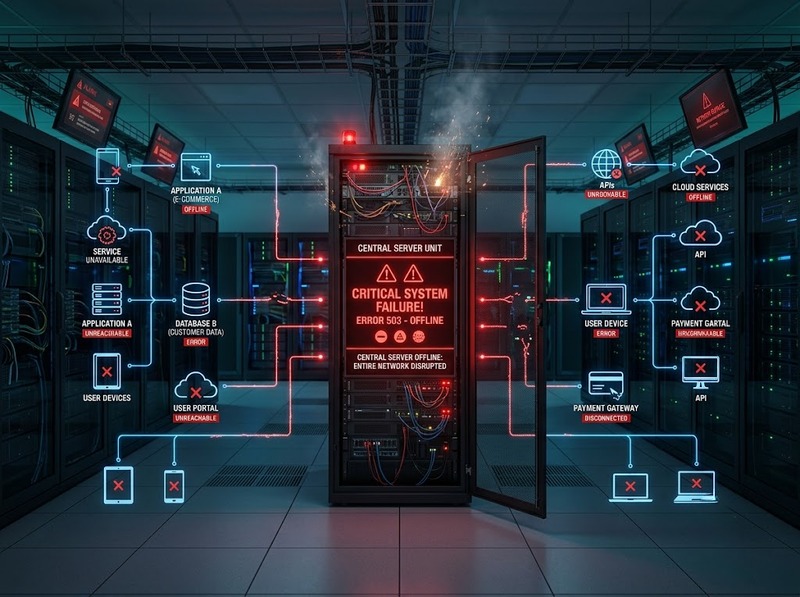
Trong các trường hợp này, dù các thành phần khác vẫn hoạt động bình thường, một lỗi tại điểm trung tâm có thể khiến toàn bộ hệ thống không thể phục vụ người dùng.
Vì sao điểm lỗi đơn có thể làm gián đoạn toàn hệ thống?
Nguyên nhân chính nằm ở sự phụ thuộc tập trung.
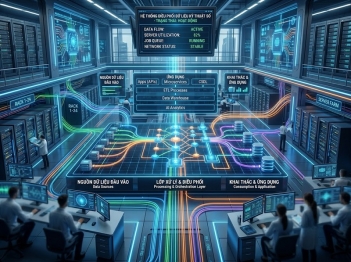
Một hệ thống công nghệ thường bao gồm nhiều lớp:
· Lớp ứng dụng
· Lớp xử lý dữ liệu
· Lớp cơ sở hạ tầng
· Lớp mạng
· Lớp bảo mật và xác thực
Nếu một lớp quan trọng chỉ có một thành phần duy nhất đảm nhiệm chức năng, thành phần đó trở thành điểm giới hạn của toàn bộ kiến trúc.
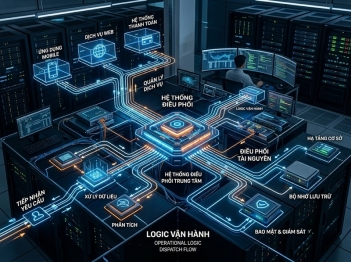
Cơ chế ảnh hưởng thường diễn ra như sau:
1. Một thành phần quan trọng gặp lỗi
2. Thành phần phụ thuộc không thể tiếp tục hoạt động
3. Yêu cầu của người dùng bị gián đoạn
4. Dịch vụ toàn hệ thống giảm khả năng cung cấp hoặc ngừng hoạt động
Ví dụ, nếu một hệ thống thương mại điện tử sử dụng một máy chủ cơ sở dữ liệu duy nhất, khi máy chủ này gặp lỗi phần cứng hoặc lỗi phần mềm, toàn bộ hoạt động như đăng nhập, tìm kiếm sản phẩm, đặt hàng hoặc thanh toán có thể bị ảnh hưởng.
Những loại điểm lỗi đơn phổ biến trong hệ thống công nghệ
Điểm lỗi đơn có thể xuất hiện ở nhiều tầng khác nhau của kiến trúc.
Điểm lỗi đơn ở tầng máy chủ
Một ứng dụng chỉ chạy trên một máy chủ vật lý hoặc một máy ảo duy nhất sẽ phụ thuộc hoàn toàn vào máy chủ đó.
Các rủi ro có thể bao gồm:
· Hỏng phần cứng
· Lỗi hệ điều hành
· Lỗi cấu hình
· Quá tải tài nguyên
Nếu không có máy chủ thay thế, dịch vụ có thể ngừng hoạt động cho đến khi sự cố được xử lý.
Điểm lỗi đơn ở tầng dữ liệu
Cơ sở dữ liệu thường chứa thông tin quan trọng nhất của hệ thống.
Nếu chỉ có một hệ thống lưu trữ dữ liệu duy nhất, các lỗi như:
· Hỏng ổ đĩa
· Sai cấu hình
· Lỗi phần mềm
· Mất dữ liệu
có thể gây ảnh hưởng nghiêm trọng đến toàn bộ ứng dụng.
Các cơ chế như sao lưu dữ liệu, nhân bản cơ sở dữ liệu hoặc chuyển đổi dự phòng giúp giảm nguy cơ này.
Điểm lỗi đơn ở tầng mạng
Hệ thống mạng cũng có thể tạo ra điểm lỗi đơn nếu chỉ sử dụng một thiết bị trung tâm.
Ví dụ:
· Một thiết bị chuyển mạch duy nhất
· Một đường truyền Internet duy nhất
· Một thiết bị cân bằng tải duy nhất
Khi thiết bị đó gặp sự cố, các hệ thống phía sau có thể mất kết nối dù máy chủ và ứng dụng vẫn hoạt động.
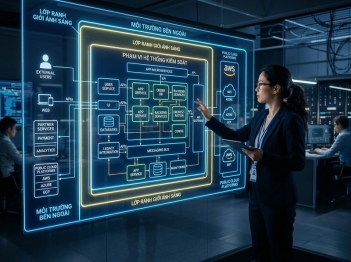
Điểm lỗi đơn trong dịch vụ phụ thuộc
Các hệ thống hiện đại thường kết nối với nhiều dịch vụ bên ngoài như:
· Dịch vụ thanh toán
· Dịch vụ xác thực
· API bên thứ ba
· Nền tảng lưu trữ đám mây
Nếu toàn bộ hoạt động phụ thuộc vào một dịch vụ duy nhất mà không có phương án thay thế, dịch vụ đó trở thành điểm lỗi đơn.
Rủi ro khi hệ thống tồn tại điểm lỗi đơn
Sự tồn tại của điểm lỗi đơn làm tăng nguy cơ mất tính sẵn sàng của hệ thống.
Các rủi ro chính bao gồm:
Gián đoạn dịch vụ
Khi thành phần duy nhất gặp lỗi, người dùng có thể không truy cập được ứng dụng hoặc không sử dụng được chức năng quan trọng.
Thời gian khôi phục kéo dài
Không có thành phần thay thế đồng nghĩa với việc đội vận hành phải sửa lỗi trước khi hệ thống có thể hoạt động trở lại.
Điều này làm tăng thời gian ngừng hoạt động (downtime).
Mất dữ liệu hoặc ảnh hưởng tính toàn vẹn dữ liệu
Nếu điểm lỗi đơn nằm ở tầng lưu trữ hoặc cơ sở dữ liệu, sự cố có thể dẫn đến:
· Mất dữ liệu
· Sai lệch dữ liệu
· Khó khôi phục trạng thái ban đầu
Giảm khả năng mở rộng hệ thống
Một kiến trúc phụ thuộc vào một thành phần duy nhất thường khó mở rộng khi lượng người dùng tăng cao.
Ví dụ, một máy chủ duy nhất có thể trở thành nút thắt cổ chai khi lưu lượng truy cập tăng đột biến.
Cách phát hiện điểm lỗi đơn trong kiến trúc hệ thống
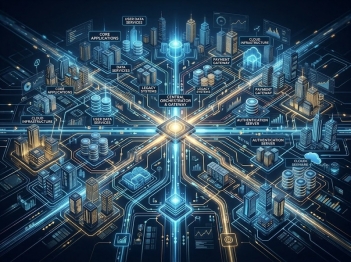
Để xác định điểm lỗi đơn, cần phân tích toàn bộ luồng hoạt động của hệ thống.
Một số phương pháp phổ biến:
Lập sơ đồ phụ thuộc hệ thống
Vẽ lại mối quan hệ giữa:
· Ứng dụng
· Máy chủ
· Cơ sở dữ liệu
· Mạng
· Dịch vụ bên ngoài
Các thành phần nằm trên đường đi bắt buộc nhưng không có phương án thay thế là ứng viên cần kiểm tra.
Đánh giá khả năng dự phòng
Đặt câu hỏi:
· Nếu thành phần này bị lỗi, hệ thống có tiếp tục hoạt động không?
· Có thành phần thay thế tự động không?
· Có cơ chế chuyển đổi dự phòng không?
Nếu câu trả lời là không, đó có thể là điểm lỗi đơn.
Kiểm tra theo các kịch bản sự cố
Các bài kiểm tra như mô phỏng mất máy chủ, mất kết nối mạng hoặc lỗi dịch vụ giúp phát hiện những điểm phụ thuộc nguy hiểm.
Cách loại bỏ hoặc giảm rủi ro từ điểm lỗi đơn
Mục tiêu không phải lúc nào cũng là loại bỏ hoàn toàn mọi điểm lỗi đơn, mà là giảm khả năng một lỗi đơn lẻ gây ảnh hưởng toàn hệ thống.
Một số giải pháp phổ biến:
Thiết kế dự phòng
Triển khai nhiều thành phần có cùng chức năng để khi một thành phần lỗi, thành phần khác có thể tiếp tục hoạt động.
Ví dụ:
· Nhiều máy chủ ứng dụng
· Cụm cơ sở dữ liệu
· Nhiều đường truyền mạng
Sử dụng cơ chế chuyển đổi dự phòng
Failover cho phép hệ thống tự động chuyển sang tài nguyên thay thế khi phát hiện lỗi.
Ví dụ:
· Chuyển sang máy chủ dự phòng
· Chuyển vùng dữ liệu
· Chuyển sang đường mạng dự phòng
Phân tán hệ thống
Các kiến trúc hiện đại như hệ thống phân tán hoặc kiến trúc đa vùng giúp giảm sự phụ thuộc vào một điểm duy nhất.
Ví dụ:
· Triển khai ứng dụng trên nhiều khu vực địa lý
· Sao chép dữ liệu giữa nhiều cụm
· Phân phối tải qua nhiều máy chủ
Xây dựng kế hoạch khôi phục sự cố
Ngay cả khi không thể loại bỏ hoàn toàn điểm lỗi đơn, hệ thống vẫn cần có:
· Quy trình phục hồi
· Bản sao lưu
· Kịch bản xử lý sự cố
· Mục tiêu thời gian khôi phục (RTO)
· Mục tiêu mất dữ liệu cho phép (RPO)
Điểm lỗi đơn khác gì với lỗi thông thường trong hệ thống?
Không phải mọi lỗi đều là điểm lỗi đơn.
Một lỗi thông thường chỉ ảnh hưởng đến một phần hệ thống và có thể được cô lập.
Trong khi đó, điểm lỗi đơn có đặc điểm:
· Là thành phần quan trọng
· Có mức độ phụ thuộc cao
· Không có phương án thay thế
· Có khả năng gây ảnh hưởng lan rộng
Ví dụ:
Một máy chủ trong cụm gồm 10 máy chủ bị lỗi có thể không gây gián đoạn nếu hệ thống có cơ chế cân bằng tải.
Nhưng một máy chủ duy nhất chứa toàn bộ dữ liệu quan trọng bị lỗi có thể khiến toàn bộ dịch vụ dừng hoạt động.
Ý nghĩa của việc loại bỏ điểm lỗi đơn trong thiết kế hệ thống
Loại bỏ điểm lỗi đơn là nguyên tắc quan trọng để xây dựng hệ thống có độ tin cậy cao.
Một kiến trúc tốt không chỉ tập trung vào việc hệ thống hoạt động khi mọi thứ bình thường, mà còn phải có khả năng duy trì dịch vụ khi một thành phần gặp sự cố.
Việc giảm điểm lỗi đơn giúp:
· Tăng tính sẵn sàng
· Giảm thời gian gián đoạn
· Tăng khả năng phục hồi
· Bảo vệ dữ liệu
· Cải thiện trải nghiệm người dùng
Đặc biệt với các hệ thống quan trọng như ngân hàng, thương mại điện tử, nền tảng doanh nghiệp hoặc dịch vụ trực tuyến quy mô lớn, việc kiểm soát điểm lỗi đơn là một phần thiết yếu trong thiết kế kiến trúc công nghệ.
Điểm lỗi đơn là một trong những rủi ro lớn nhất trong kiến trúc hệ thống vì nó tạo ra sự phụ thuộc vào một thành phần duy nhất. Khi thành phần đó gặp sự cố, toàn bộ hệ thống có thể bị ảnh hưởng.
Giải pháp cốt lõi là nhận diện các điểm phụ thuộc quan trọng, xây dựng cơ chế dự phòng, triển khai chuyển đổi tự động và thiết kế hệ thống theo hướng có khả năng chịu lỗi (fault tolerance). Một hệ thống ổn định không phải là hệ thống không bao giờ xảy ra lỗi, mà là hệ thống có khả năng tiếp tục hoạt động khi lỗi xảy ra.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm
Bài xem nhiều